第三者プログラムの権利関係および適用されるライセンス条件を明確化するため、
ソフトウェア使用許諾契約書の一部を改定いたします。
本改定は、第三者プログラムに関する記載の明確化を目的とするものであり、
当社プラグインの利用料金や利用可能サイト数等に変更はありません。
改定後の契約書は、以下よりご確認いただけます。
改定日:2026年11月11日
Blog
第三者プログラムの権利関係および適用されるライセンス条件を明確化するため、
ソフトウェア使用許諾契約書の一部を改定いたします。
本改定は、第三者プログラムに関する記載の明確化を目的とするものであり、
当社プラグインの利用料金や利用可能サイト数等に変更はありません。
改定後の契約書は、以下よりご確認いただけます。
改定日:2026年11月11日
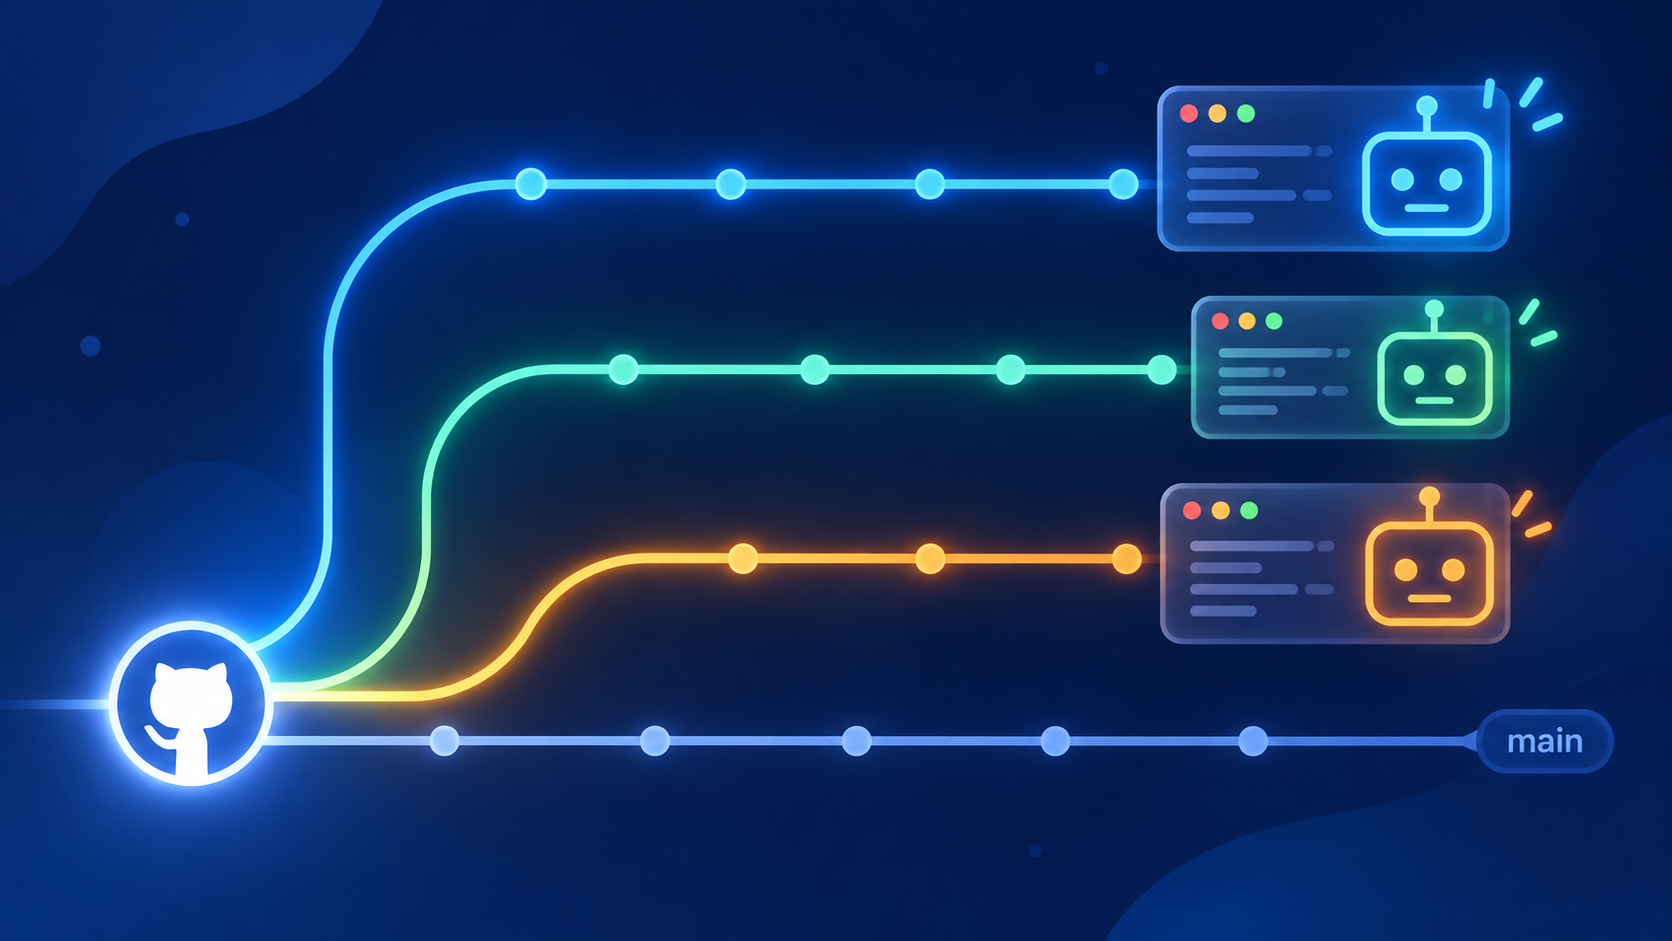
docker-compose.yml は変えず、worktree用のcomposeファイルを1つ足しただけで済んだ。localhost とCSRF、差分の比較対象、root所有のファイル、中断時に残るもの、Workflowの呼び出し方)。Laravel + InertiaのB2B向けECを、Claude Codeを中心にしたチームで開発しています。Issueを1件渡すと、実装・検証・レビューを経てDraft PRまで自律で進める仕組みを自作して使っていて、この記事ではこれを「ハーネス」と呼びます。
「ハーネス」は、一般的にまだ定義にブレがある言葉ですが、この記事の中では、複数のAIエージェントに作業を割り振り、決まった手順で動かすためのスクリプトをハーネスと呼びます。具体的には、Claude CodeのWorkflow機能で書いたJavaScriptです。どの段階をどのエージェントに任せるか、どの順に進めるか、検証が通らなければ何回までやり直すかをコードで決めておき、各段階の中の作業はエージェントが行います。
当初はIssueを1件ずつ直列に処理していました。その頃の問題は2つです。
git checkout やコミットをするので、その間に人が別ブランチで作業すると衝突します。人はハーネスが終わるまで待つことになります。そこで、git worktreeでIssueごとに作業ツリーを分けることにしました。この記事では、Docker前提のプロジェクトでworktreeを使うための構成と、運用中に起きた問題を紹介します。
git worktreeは、1つのリポジトリに作業ツリー(ファイルをチェックアウトしたディレクトリ)を複数持たせるgitの機能です。
# ../feature-a に、ブランチ feature-a をチェックアウトした作業ツリーを作る
git worktree add ../feature-a feature-a

git worktree list                # 作業ツリーの一覧
git worktree remove ../feature-a # 作業ツリーを消す(ブランチは残る)
作った作業ツリーは、それぞれ別のブランチをチェックアウトした独立したディレクトリになります。一方の作業ツリーで git checkout やコミットをしても、もう一方のファイルは変わりません。
リポジトリをもう1つ別ディレクトリにcloneする方法と比べると、次の点が違います。
.git の中身(コミットやオブジェクト)は元のリポジトリと共有するので、ダウンロードし直す必要がなく、ディスクも余計に使わないハーネスがIssueごとにworktreeを作り、その中でブランチを作って実装すれば、人間はメインの作業ツリーで関係なく作業を続けられます。gitの側は git worktree add の1行で済みます。
問題はコンテナの側です。このプロジェクトでは、1つの docker-compose.yml で次のコンテナを動かしています。
| サービス | 役割 |
|---|---|
| web | nginx + PHP-FPM。Laravelのアプリ本体で、ソースはホストからマウントする |
| vite | Node。開発サーバー(HMR)と、フロントエンドのビルド・lint |
| mysql | MySQL 8.4 |
| redis | Redis 7 |
| phpmyadmin | DBの閲覧用 |
| mailhog | アプリが送るメールの受け口 |
| minio | S3互換のストレージ(バケットを作るための使い捨てのコンテナも付く) |
| stripe-cli | StripeのWebhookをローカルに転送する。必要なときだけ起動 |
| e2e | PlaywrightのE2E。必要なときだけ起動 |
どれも同じDockerのネットワークに参加していて、サービス名で互いを解決します。ほとんどのサービスは container_name を指定し、ホストにポートを公開しています。
テストもビルドもコンテナの中で実行するので、worktreeごとに、そのファイルをマウントしたコンテナが要ります。ところが、メインと同じcomposeファイルでworktreeごとにコンテナ一式を起動すると、次のことが起きます。
docker compose up すると、container_name とホストポートが衝突するまた、メインの docker-compose.yml は人間が普段の開発で使っているので、並列化のために変えることはしたくありません。
ハーネスがコンテナの中ですることを見ると、必要なものは限られます。
docker compose exec で完結するsqlite:memory で動く。MySQLを使うのは migrate の確認くらいそこで、次のように構成しています。
container_name は付けず、別のcompose project名で起動します。nunolab_wt_<issue番号> というデータベースを作り、RedisはworktreeごとにDB番号を変えます。これらはworktree用のcomposeファイル docker-compose.worktree.yml を1つ足すだけで実現でき、メインの docker-compose.yml は変えずに済みます(ファイルの中身は問題1で紹介します)。
worktreeはIssueごとに1つ作ります。ベースブランチの最新のコミットから git worktree add --detach で作り、その中でハーネスがブランチを作ります。メインの作業ツリーには触りません。
ハーネスは親子の2段構成です。親ハーネスがIssueごとに「worktreeの用意 → 子ハーネスをworktreeに向けて起動 → 片付け」を並列に実行します。子ハーネスは、もともとIssueを1件ずつ処理していたハーネスそのもので、中身は変えていません。用意と片付けは、それぞれ担当のエージェントがシェルで行います。
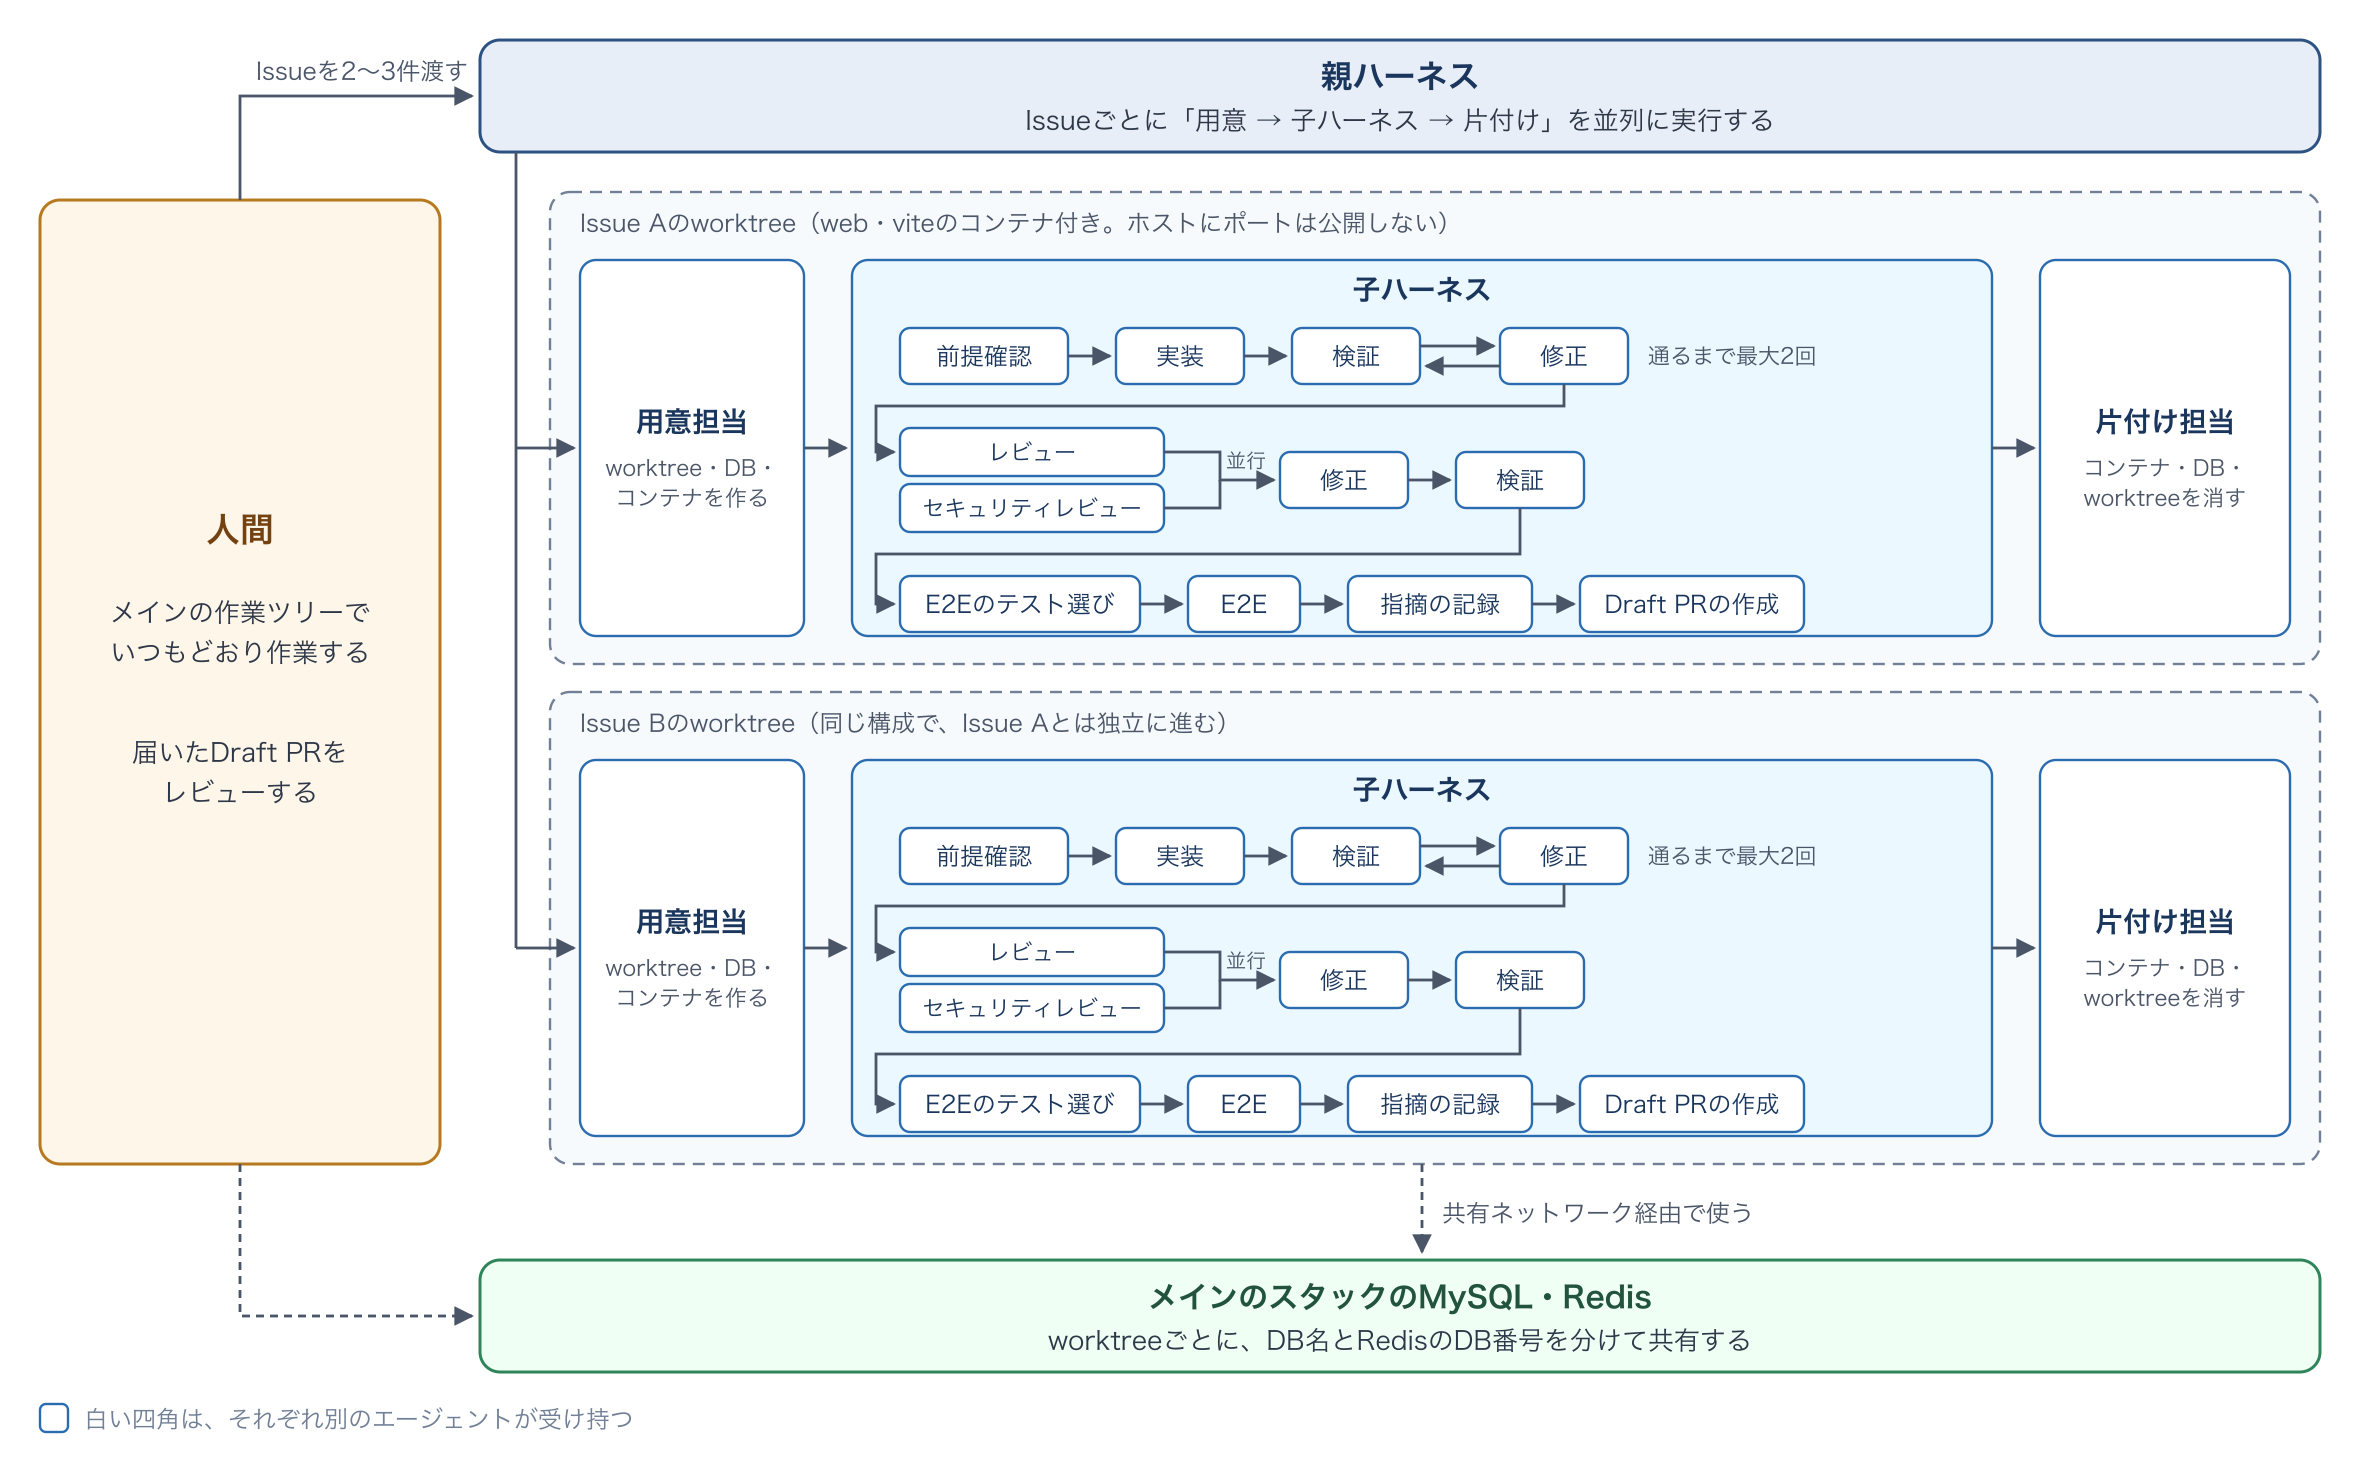
worktreeの .env はメインのものをコピーし、次の3行だけ書き換えます。
DB_DATABASE=nunolab_wt_<N>   # worktree ごとの database
REDIS_DB=2                   # 同時に実行する Issue の順に 2, 4, 6 …(メインは 0 と 1)
REDIS_CACHE_DB=3             # REDIS_DB + 1
DB_HOST と REDIS_HOST は変えません。共有ネットワーク上で、メインの mysql と redis がそのまま名前で見えるからです。データベースはメインのMySQLにrootで作ります。
docker compose exec -T mysql mysql -uroot -p"$MYSQL_ROOT_PASSWORD" -e "
  CREATE DATABASE IF NOT EXISTS \`nunolab_wt_<N>\` CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
  GRANT ALL PRIVILEGES ON \`nunolab_wt_<N>\`.* TO '<アプリのユーザー>'@'%';"
コンテナの起動には、worktreeごとのcomposeコマンドをシェル関数にしたものを使います。
MAIN=$(git rev-parse --show-toplevel)
WT="$MAIN/.worktrees/wt-<N>"
dc() { docker compose --project-directory "$WT" -p nunolab_wt_<N> -f "$MAIN/docker-compose.worktree.yml" "$@"; }

dc up -d
dc exec -T web composer install --no-interaction
dc exec -T vite npm cicomposeファイルはメインツリーの絶対パスで指定し、--project-directory で ./ をworktreeに向けます。こうすると、worktreeにチェックアウトしたコミットにcomposeファイルが含まれていなくても(=composeファイルがまだmainにマージされていなくても)動きます。
動くようになった後、運用中に次の6つの問題が起きました。
| # | 起きたこと | 対処 |
|---|---|---|
| 1 | メインのE2Eが、worktreeの web にアクセスしてしまう |
共有ネットワークには待機用のコンテナだけを参加させる |
| 2 | localhost でアクセスするとCSRFの照合が省略され、CSRFのテストが必ず失敗する |
localhost 以外の名前(wt-app)でアクセスする |
| 3 | 差分をローカルの main と比べると、マージ済みの変更までレビューされる |
origin のブランチと比べる |
| 4 | rootが作ったファイルを消せず、worktreeを消せない | 消す前に、コンテナの中でファイルの持ち主を戻す |
| 5 | 中断すると、worktreeやコンテナ、DBが残る | 残ったworktreeで子ハーネスを起動し、続きから進める |
| 6 | 実行中のWorkflowから、自作のWorkflowを名前で呼べない | スクリプトのパスで呼ぶ |
起きた場所で分けると、1と2がDockerのネットワーク、3〜5がworktreeの作成から片付けまで、6がハーネス自体の問題です。以下、順に説明します。
web にアクセスしてしまうE2E(Playwright)を導入した後、メイン側のE2Eが、変更と関係のないところでときどき失敗するようになりました。
原因はcomposeの仕様です。composeは、ネットワークに参加するコンテナにサービス名を別名として必ず付けます(無効にする設定はありません)。worktreeのwebが共有ネットワークに web という別名で参加すると、メインのE2Eがアクセスする http://web:3000 がworktree側のwebに解決されることがありました。
対処として、待機するだけの net というサービスを追加し、共有ネットワークにはそれだけを参加させるようにしました。webとviteは network_mode: service:net でそのネットワーク名前空間を共有します。
最終的な docker-compose.worktree.yml は次のとおりです(E2E用のサービスなどは省いています)。
services:
  # 共有ネットワークに参加するのはこれだけ。待機するだけのコンテナ
  net:
    image: node:24.22.1-alpine
    command: sleep infinity
    extra_hosts:
      - "wt-app:127.0.0.1"   # 問題2で使う
    networks: [shared]

  web:
    image: ${MAIN_PROJECT:-nunolab}-web   # メインでビルド済みのイメージを使い回す
    volumes:
      - ./:/var/www/html                  # ./ は --project-directory で指した worktree
    network_mode: service:net             # net の network namespace を共有する

  vite:
    image: node:24.22.1-alpine
    working_dir: /var/www/html
    command: sleep infinity               # lint / build 専用。HMR サーバーは起動しない
    volumes:
      - ./:/var/www/html
      - node_modules:/var/www/html/node_modules
    network_mode: service:net

volumes:
  node_modules:

networks:
  shared:
    external: true                        # メインスタックが作ったネットワークに参加する
    name: ${MAIN_PROJECT:-nunolab}_b2b_promo_network
これで共有ネットワーク上の web はメインのものだけになり、worktreeからは今までどおり mysql や redis を名前で解決できます。ホストのポートは1つも公開していないので、いくつ並べても衝突しません。
MAIN_PROJECT はメインのcompose project名です。メインのディレクトリ名が環境によって違っても動くように、用意担当のエージェントが起動中の mysql コンテナのラベルから実際の名前を調べ、worktreeの .env に書いています。
localhost だとCSRFのテストが必ず失敗する問題1のとおり、web という名前はメインや他のworktreeのwebにもつながりうるので、worktreeのE2Eは最初 http://localhost:3000 でアクセスしていました。すると、「CSRFトークンが無効なままフォームを送ると 419 のページが出る」ことを確かめるテストだけが、419 ではなく 302 になって毎回失敗しました。
localhost はブラウザにとって「安全なコンテキスト」なので、フォームの送信に Sec-Fetch-Site: same-origin ヘッダーが付きます。Laravelはこのヘッダーがあると、CSRFトークンを照合せずにリクエストを通します。そのため、トークンが無効でも 419 になりません。アプリの不具合ではなく、テストする環境の問題です。
当初は、ハーネスのプロンプトで「このテストの失敗は環境が原因として扱う」と指示してしのいでいました。しかしこれでは、本当にCSRFの処理を壊したときにも、同じく環境のせいとして片付けられてしまいます。この点は、レビュー担当のエージェントからも指摘されました。
そこで、localhost 以外の名前でアクセスするようにしました。上の docker-compose.worktree.yml で、net の extra_hosts に wt-app:127.0.0.1 を足しています。webとviteは net のネットワーク名前空間を共有しているので、/etc/hosts も共有され、E2Eからは http://wt-app:3000 で自分のworktreeのwebに届きます。wt-app は安全なコンテキストではないので、Sec-Fetch-Site は付かず、CSRFトークンの照合が行われます。
あわせて、プロンプトの「環境が原因として扱う」という指示は外しました。worktreeの中でE2Eを実行し、419 のテストを含めて通ることを確かめています。
main と比べると、マージ済みの変更までレビューされるworktree内のローカル main は、worktreeを作った時点のままです。そこを基準に git diff main...HEAD を取ると、他のIssueですでにマージされた変更まで自分の差分に含まれ、レビュー担当のエージェントが「Issueの範囲外の変更がある」と指摘していました。比較の基準は origin/<base> に統一し、ハーネスのJSで1箇所に定義しています。
// ローカルの main は worktree を作った時点のままなので使わない
const DIFF_BASE = `origin/${base}`
// レビュー担当へのプロンプトでは、git fetch origin のあとに
// git diff ${DIFF_BASE}...HEAD で比べるよう指示するwebコンテナはrootで動くため、vendor/ や storage/ のファイルはrootの所有になり、ホストのユーザーでは消せません。そのため git worktree remove が失敗し、片付け担当のエージェントは「worktreeの外をマウントしたコンテナで rm -rf する」という方法を取るようになりました。これはworktreeの外まで消しかねない操作です。
いまは、down の前に webコンテナの中からworktreeを chown -R <ホストの uid:gid> で持ち主に戻し、ホストのユーザーのまま git worktree remove を実行しています。
# 1. down より前に、コンテナの中から持ち主をホストのユーザーに戻す
#    $(id -u) はホスト側で展開されるので、ホストの uid がそのまま渡る
dc exec -T web chown -R "$(id -u):$(id -g)" /var/www/html

# 2. コンテナを止めて volume ごと消す
dc --profile e2e down -v

# 3. ホストのユーザーのまま worktree を消す(ブランチは残る)
git worktree remove --force "$WT"

# 4. database も消す(3 が失敗しても実行する)
docker compose exec -T mysql mysql -uroot -p"$MYSQL_ROOT_PASSWORD" \
  -e "DROP DATABASE IF EXISTS \`nunolab_wt_<N>\`;"
chown の対象はコンテナの /var/www/html、つまりそのworktreeをマウントした範囲だけなので、worktreeの外には触れません。外側をマウントしての削除やsudoでの削除はプロンプトで禁止しました。3が失敗したときは、別の方法で消そうとせず、残ったファイルの例を報告して止まります。
APIの上限などで途中で止まると、片付けも実行されず、worktree・コンテナ・DB・ブランチが残ります。
一方で、実装担当のエージェントはworktreeの作業ツリーに変更を書くだけで、コミットはしません。つまり worktreeを消さなければ、途中までの実装は残っています。そこで、捨ててやり直すのではなく、次の手順で続きから最後まで進めています。
git worktree add が、残っているworktreeとぶつかって失敗するからです。docker compose ls -a で確かめる。// worktree ごとに1件ずつ起動する
{
issue: <N>,
base: 'main',
workdir: '<メインのツリー>/.worktrees/wt-<N>',
dc: 'docker compose --project-directory <メインのツリー>/.worktrees/wt-<N> -p nunolab_wt_<N> -f <メインのツリー>/docker-compose.worktree.yml',
}git worktree prune を実行する。ブランチとPRは残します。片付けはシェルのコマンドだけで済み、エージェントは要りません。APIの上限に当たっている最中でも片付けられます。
親ハーネスから子ハーネスを workflow('child-harness', …) のように名前で呼ぶと、全Issueが no workflow with that name で失敗しました。実行中のWorkflowの中では、名前で呼べるのは組み込みのWorkflowだけだからです。対処として、パスで直接指定するようにしました。
// NG: 実行中の Workflow からは、自作の Workflow を名前で呼べない
await workflow('child-harness', args)

// OK: スクリプトのパスで指す(相対パスはリポジトリのルート基準で解決される)
await workflow(
  { scriptPath: '.claude/workflows/child-harness.js' },
  { issue, base, workdir: setup.workdir, dc: setup.dc },
)子には、用意担当が作ったworktreeのパス(workdir)と、そこで使うcomposeコマンド(dc)を渡します。これで子ハーネスを変えずに、worktreeの中で動かせます。
docker-compose.yml は変えていない数字で見ると、ハーネスが作ったPRは、もっとも多かった3週間で277件、多い日は1日46件でした。ハーネスを使い始めてから最初の2か月半ほどは、合計8件です(親ハーネス経由と、子ハーネスを単独で実行したものの両方を含みます)。
実装が速くなったことで、別の問題が出てきました。
レビュー担当のエージェントは、指摘を2種類に分けて返します。このPRで直すべきものは、ハーネスがその場で直します。直すほどではないが気になる点は、1件ずつファイルに記録し、後で人間がIssueにするかどうかを決めます。
当初は、気になる点をできるだけIssueにしていました。すると、「Issueを実装する → レビューが新しい気になる点を出す → それをIssueにする → そのIssueを実装する」という循環ができます。並列化で実装が速くなったぶん、この循環も速く進みました。上のPRが277件作られた3週間に、新しく作られたIssueは322件で、PRの数を上回っていました。PRを作るそばから同じくらいIssueが増えるので、残っているIssueは40〜50件前後のまま減りませんでした。
そこで方針を変え、Issueにするのは金額・権限・データの消失に関わるような致命的な問題だけにしました。それ以外の気になる点は、記録に残すだけにしています。その後、新しく作られるIssueは週に10〜30件台まで減りました。
並列化もできて、人間が待たされなくなったことは大きな改善でした。しかし、待たなくてよくなったぶん、Draft PRは人間がレビューする速さを超えて届くようになりました。1件レビューし終わる頃には、次の2件が並んでいます。ハーネスを待つ時間がなくなりましたが、永遠にレビューし続けなくてはならなくなりました🥲
プロフィール
SAWAKO(サーバーサイドエンジニア/2025年 中途入社)
経歴
大学院にて知能機能システム工学を修了後、国内SIerでの発電所システム設計・PMや、メーカーでのメカニカルエンジニアとして、宇宙開発から自動車分野まで幅広い設計・解析を経験。その後、Web領域への興味からソフトウェアエンジニアへ転身を果たす。
夫の海外赴任に伴う渡米中は、日本企業の業務にフルリモートで携わりながら、現地の大学で開発を体系的に学び直し、帰国後ジョーレンへ入社。現在はPMとしてEC-CUBE案件を要件定義からリリースまで一貫して牽引しており、持ち前の明るさと高い成長意欲でチームを引っ張る信頼のエースとして活躍中。
転職を決めたきっかけは
アメリカからの帰国を機に、日本で改めてキャリアを築くにあたり、新しい環境へ挑戦したいと考えました。前職に戻る選択肢もありましたが、今後の成長を見据え、よりメンバー間のコミュニケーションが活発で、相談しやすい環境で働きたいという思いが強くなったためです。実際の面談を通じて、ジョーレンにはチームで協力し合う文化と、一人ひとりが主体的に取り組める理想の環境があると実感しました。
また、エンジニアとして専門性を高める上で、EC領域に特化して深く知識や経験を積み成長していける点にも魅力を感じ、入社を決意しました。
主な担当業務について
現在は、EC-CUBEのカスタマイズ開発をはじめ、PM(プロジェクトマネージャー)としてクライアントからの要件定義や仕様策定、エンジニアとの連携を含めた全体の進行管理までを一貫して担当しています。
Web系エンジニアとしての実務経験は約3年ですが、前職のメカニカルエンジニア時代に培った顧客折衝力や、徹底した品質管理のノウハウは、今の仕事にも活かせていると感じています。過去の経験を土台にした確実なプロジェクト進行を強みに、チームをしっかりと引っ張っていけるよう、日々の業務に取り組んでいます。
仕事をする上で大切なこと
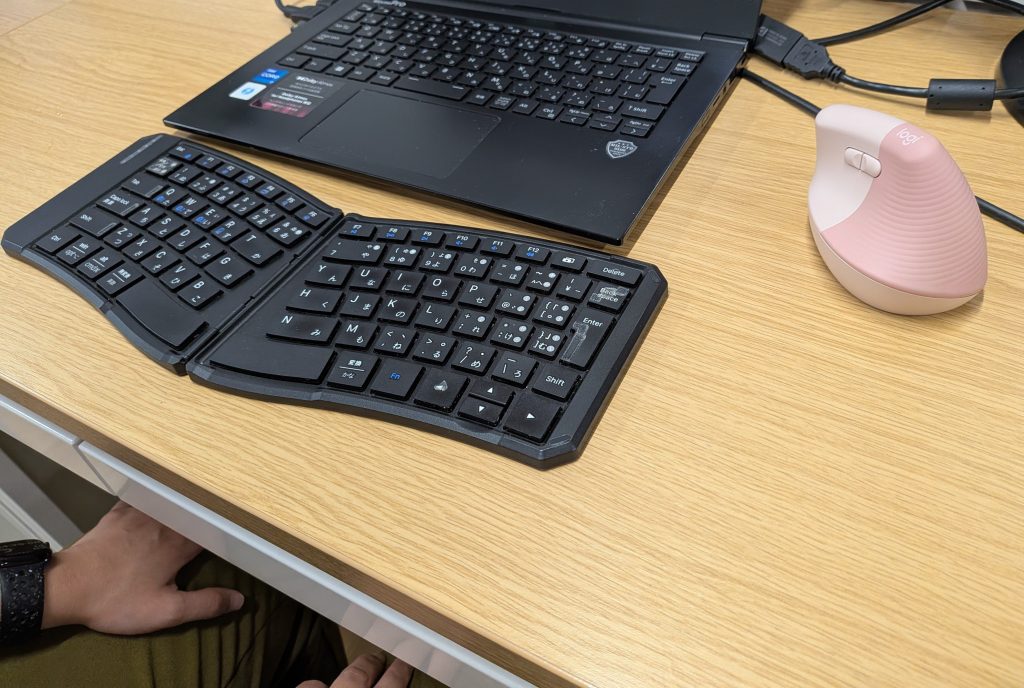
仕事をするうえで、特にリモート環境下では「自分の現状を周りに伝えること」を最も大切にしています。姿が見えないからこそ、結果の報告だけでなく、今どこで立ち止まっているかという経過もオープンに発信し合うことで、トラブルを未然に防ぎ、互いにフォローし合えると考えています。顧客や社内から信頼して仕事を任せてもらうためにも、受け身にならず発信することは欠かせません。実は人見知りな面もあり決して得意なわけではないのですが、そこは自ら進んで頑張るようにしています。
ジョーレンでの働き方について
ジョーレンはとても働きやすく、ストレスの少ない環境だと感じています。入社前は「制度上はリモートワークやフレックスと言ったって、実態はどうなんだろう」と少し不安もありましたが、乖離はなく、本当にメリハリを利かせて仕事ができる環境でした。
リモート中心ですが、わからないことがあれば気軽に質問でき、レスポンスも早いため日々安心して業務に取り組めています。入社時の「いつでも質問して大丈夫」という言葉通り、相談を歓迎する文化が根付いています。また、各メンバーが自己管理を徹底し、高い主体性を持って成果を出しているのも印象的で、だからこそ互いに信頼し合って働けているんだと実感しています。
今後の目標は?
今後の目標は、社内外から技術的に深く頼られる存在になることです。キャリアチェンジを経て様々な経験をしてきましたが、私のベースにあるのはやはり「ものづくりが好き、技術が好き」という想いです。だからこそ、ただ仕様通りにコードを書く枠に留まらず、お客様としっかり対話を重ねて、本質的な課題を技術の力で解決できる「テックリード」を目指したいと考えています。
これまで培ってきたPMとしての顧客折衝力と、エンジニアとしての技術力を掛け合わせ、ジョーレンの技術的な成長を牽引しながら、お客様にもチームにもより大きな価値を還元していきたいです。
これから応募する方へメッセージ
繰り返しにはなりますが、ジョーレンはエンジニアにとって本当に安心して働ける環境です。わからないことを相談しやすい雰囲気があり、リモートでも周囲としっかりコミュニケーションが取れるため、新しい環境に不安がある方でも一歩を踏み出しやすいと思います。また、日々の業務で気づいたことや改善提案も伝えやすく、一人ひとりの意見を大切にしてもらえる職場だと実感しています。
「チームで協力しながら成長したい」「お互いの考えを伝え合いながら仕事をしたい」という方には、これ以上ない環境です。迷っているなら、ぜひ一歩踏み出して応募してみてください。一緒に働けるのを楽しみにしています!
松戸エピソード
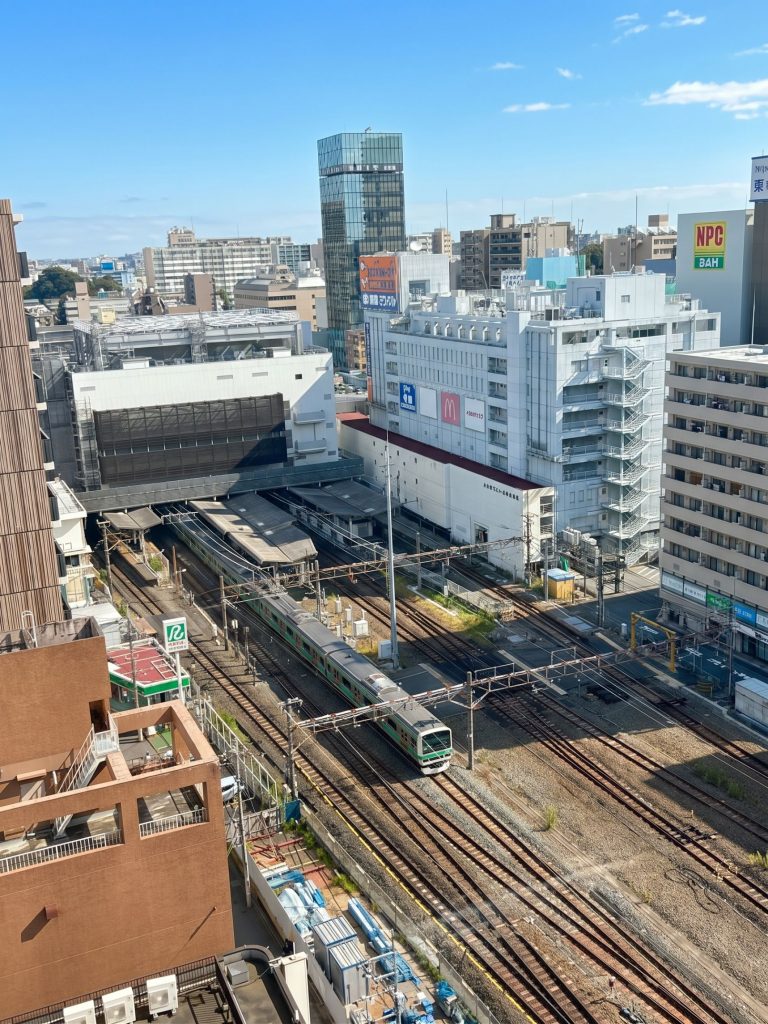
学生時代や前職での通勤で、長らく常磐線を使っていたので松戸の存在は知っていたのですが、当時はただの「通過する場所」でした。そのため、ついにここで働く日が来たか!と、どこか感慨深い気持ちです(笑)。現在は群馬からのフルリモート勤務が中心で、オフィスへ行くのは年に数回の出社日くらいですが、上野から直通なので新幹線を使う私にとってはすごく交通の便が良いんです。
歴史があって、古き良き都会の趣を感じられる街並みもあり、何より全国的に有名なラーメン店「とみ田」があることも、外せないポイントですね。
大学卒業後、営業職として社会人スタートを切るも将来性のある業界で手に職をつけ働きたいと考え転職を決意。 25歳の時に未経験でIT業界へ飛び込み、主にSES契約のもと多様な案件に参画しながら体当たりでJavaやPythonによるwebアプリケーション開発のスキルを身につける。
ジョーレンに入社後は、当社チームの一員としてグループ会社のプロダクト開発に参画。 C#.NETでの開発は初めてだったが、持ち前の吸収力と上司のサポートのもとメキメキと力をつけ活躍中。 穏やかな物腰の裏に芯の強さを感じさせる人柄と丁寧な仕事ぶりで周囲の信頼を獲得している。
エンジニアとして専門的な強みを持ちたかったからです。
前の会社では、案件が変わると言語も開発するプロダクトもバラバラ、行く先々ですべてイチから始める形になりスキルが積みあがっていく実感を得ることが難しかった。
特に後半は若手とともに現場に入り立ち上がりを指導・支援する立場となり、育成のやりがいは感じつつも、自分自身は短期間で現場を転々とする状況に拍車がかかっていました。
自分の将来を考え「特定の領域に強みを持っていること」「要件定義~納品まで一気通貫で開発ができること」、この2点を軸に転職先を探しているなかでジョーレンと出会いました。
グループ会社のプロダクトにあたるECサイトと連携したメールサービスを開発しています。
すでに先輩たちが参画しているなかジョーレンチームの一員として加入しました。 業務自体は自社内で行っており、打ち合わせは全てリモートです。
体制はスクラム開発、スプリントは1週間単位ですね。 プロダクトオーナーから要望をいただいて調査・設計・実装・テストを担当しています。 毎週水曜日・木曜日に定例ミーティングがあり、1週間で対応する範囲を決めたり、開発後のレビューを受けます。
不具合が発生した際の応急対応や報告も発生しますが、通常業務時間内のみの対応なのでそこまで負担感はありません。
環境として大切にしたいのはチームワークです。それでいうと今のチームは過去の経験のなかでNo.1。
雰囲気がいいというだけではなくチームがしっかり機能しているので、働きがいがあり他のメンバーから学ぶことも多い。いい環境で働けていると思います。これは大変な状況も経験してきたからこそ強く感じることかも(笑)
個人的に大切にしているのは作業もコミュニケーションも丁寧に行うということ。 スクラム開発なので、業務が属人化しないよう配慮しつつ一方でフレキシブルに動く必要があります。あとから困ることがないよう受け取る側をイメージしながら仕事をするよう心がけています。
前の会社では案件次第で出社になったりリモートになったりと働き方に影響がありましたが、ジョーレンではそれがないので安心感がありますね。
今はフルリモートで勤務しています。朝会や1on1など定期的なコミュニケーションの機会が確保されているので、リモートでも業務に支障は感じていません。 通勤していた時と比べるとかなり自分の時間が増え、夕飯づくりが私の担当になりました(笑)
また、C#を扱うのが初めてだったので、勉強がてら開発時のテストをサポートするアプリケーションツールを業務外で作っています。これも時間ができたのでできるようになったことのひとつです。
エンジニアとして「これが得意です」と言える柱を自分のなかで持ちたい。
今携わっている領域や言語の理解をもっと深めて、業務的にコアな部分でも活躍できるようなエンジニアになりたいと考えています。
また、今後上流工程での顧客対応が増えてきたり、後輩指導が必要となってきた際のコミュニケーションの引き出しも増やしたい。 穏やかだけど、芯があって説得力があるひとはかっこいいなと感じます。今まで出会った尊敬する先輩たちをイメージしながら、それに近づけるよう日々頑張っているところです。
転職って本当のところは入社してみないとわからない部分がどうしてもあると思いますが、ジョーレンは入社前後のギャップがあまりなかったので、気になるようならぜひ応募してみて欲しいです。
この規模にしては会社運営に安定感があって、ECという強みもあり、自分としては安心して働くことができています。最近は組織サーベイというのも導入され課題をそのままにせず改善しようという気風がある。
リモート勤務のメンバーが多いので、+αの情報を得るには自分から動く必要が出てくる場面はありますが、声を受け止める体制はチームにも会社にもあると感じるので、ある程度自分から発信ができれば問題ないです!
実は松戸を訪れたのは採用面接が初めてでした(笑)隣の柏にはたまに遊びに来たりしていたんですけどね。
ほどほどに栄えていて少し歩けば自然もあるし、過ごしやすい環境です。
お酒が好きなんですが、オフィス周辺も飲み屋さんが結構あるようなので出社したときに開拓したいと思ってます。
もしこのページを見て入社してきてくれたひとがいたら、一緒に飲みに行きたいですね。
近年、AI技術の進化に伴い、EC業界で急速に注目を集めている言葉が
「エージェンティックコマース(Agentic Commerce)」です。
これまでECサイトでの買い物といえば、
「ユーザーが検索窓にキーワードを入力し、商品一覧から比較してカートに入れる」
という流れが一般的でした。
しかし、エージェンティックコマースの登場によって、
その買い物のプロセス自体が根底から変わろうとしています。
今回は、エージェンティックコマースの基本概念から、
EC事業者が知っておくべきポイント、
そして今後のEC基盤の変化について分かりやすく解説します。
エージェンティックコマースとは、
AIエージェント(自律型AI)が消費者に代わって商品の検索・比較・選定・さらには購入手続きまでを自律的にサポート・実行する新しい購買プロセスのことです。
従来の「検索型コマース」では、ユーザー自身が情報を集めて判断する必要がありました。
しかし、エージェンティックコマースでは、
ユーザーがAIに対して対話形式でアバウトな要望を伝えるだけで、
AIが最適な商品を提案し、買い物を完結させてくれます。
従来のECとエージェンティックコマースの違い
具体的な利用イメージ
「来月キャンプに行くので、初心者でも扱いやすくて雨に強い2人用のテントを探して購入しておいて」
このように指示を出すだけで、
AIエージェントが各ECサイトのデータを読み解き、
予算や評価、配送納期まで考慮して最適な商品を提案・決済まで行ってくれる世界観です。
注目される背景には、大きく分けて3つの要因があります。
エージェンティックコマースが浸透していく中で、EC事業者はどのような対応を行うべきでしょうか。
エージェンティックコマースは、
消費者の買い物をより快適にするだけでなく、
EC事業者の集客や販売のあり方を大きく変える可能性を秘めています。
人だけでなく「AIにとっても扱いやすいECサイト」を構築することが、
これからの時代を生き抜くキーワードになるでしょう。
なお、国内シェアNo.1のオープンソースEC基盤である
EC-CUBE(最新版「EC-CUBE 4.4」)においても、
このエージェンティックコマースに対応し、
AIフレンドリーなコマース基盤へと進化することが発表されています(※)。
株式会社ジョーレンでは、EC-CUBEプラチナパートナーとして、
最新のテクノロジートレンドやAI活用を見据えたECサイトの構築・カスタマイズをご提案しております。
これからの時代に合わせたECサイトの運用や改修をお考えの事業者様は、
ぜひお気軽にご相談ください。
(※)EC-CUBE プレスリリース「EC-CUBE最新版、AIフレンドリーなECオープンソースへ進化。AIが消費者の最適な購買をサポートする「エージェンティックコマース」に対応。(2026/05/15)」
https://www.ec-cube.net/press/detail.php?press_id=350
ec-cube/api44 が必須(認証と公開範囲の定義を担当している)bin/consoleから人力で叩くこともできる(ツールがそのままコマンドになっている)、AI クライアントからは HTTP + トークンTRUSTED_HOSTS の設定が必須検証は 2026-09-08 時点の 4.4 ブランチ(
efa640d)と eccube-api4 の 4.4 ブランチ、同梱の docker-compose 構成(PHP 8.2 / Apache / PostgreSQL 18)で行いました。どちらも開発中なので、正式版で挙動が変わる可能性があります。この記事はClaude Opus 5が執筆しています。
MCP(Model Context Protocol)は、AI クライアントに外部データやツールを渡すための標準プロトコルです(公式サイト、Anthropic の発表)。
EC-CUBE 4.4 はこのサーバ側をコアに実装しました。4.4 全体の位置づけとリリース時期は公式ロードマップ #6762 にあります(正式版は 2026年10月下旬予定)。
用意されているツールは11個で、すべて読み取り専用です。書き込み系のツールはありません。必要なスコープはツールごとに決まっていて、対応は src/Eccube/Service/Mcp/McpToolScopeMap.php の1箇所に定義されています。
| ツール | 内容 | 必要スコープ |
|---|---|---|
search_products / get_product / get_product_stock |
商品検索・商品詳細・在庫 | mcp:product:read |
search_orders / get_order / get_shipping |
受注検索・受注詳細・配送 | mcp:order:read |
search_customers / get_customer / get_customer_orders |
会員検索・会員詳細・購入履歴 | mcp:customer:read |
list_plugins / get_plugin |
プラグイン一覧・詳細 | mcp:plugin:read |
有効化は既定 OFF(BaseInfo の mcp_enabled が false)で、店舗設定(/admin/setting/shop)のトグルから明示的に行います。無効の間は /admin/mcp が 404 を返し、エンドポイントの存在自体を明かしません。
Docker Compose での環境構築は公式ドキュメントのとおりなので省略します(Docker Compose を使用したインストール、システム要件)。今回は 4.4 ブランチを clone して PostgreSQL 18 の構成で立てました。
データが無いと MCP のツールを試せないので、ダミーデータを生成します。
bin/console eccube:fixtures:generate \
  --products=50 --orders=30 --customers=30 --without-image
商品52件・受注900件・会員30件が入りました。商品名は文学作品のテキストから切り出されるので意味不明な文字列になりますが、件数と構造の確認には十分です。
環境構築で3点つまずいたので記録しておきます。
GID を渡すと起動しない(groupmod: GID '20' already exists)。UID だけ渡す.env は必要。 無いと DB 設定が届かず、エラーにならずに SQLite へフォールバックします(doctrine.yaml の既定 driver が pdo_sqlite)。症状は「CLI は動くのに Web だけ 500」docker compose exec を root で叩くと Web が 500 になる。 監査ログが root 所有で作られ、Apache が追記できなくなります。-u www-data を付ける(復旧は chown -R www-data:www-data var vendor)MCP クライアントを用意する前に、CLI で全ツールを試せます。11個のツールが 1ツール1コマンドとして生えています。
$ bin/console list eccube
...
  eccube:cli:get_customer            EC-CUBE の会員 ID から会員詳細 (氏名・連絡先・住所など) を取得する。 読み取り専用。 必要 scope: mcp:customer:read。 allow_list に PII が含まれる。
  eccube:cli:get_customer_orders     EC-CUBE の指定会員の購入履歴 (注文一覧) を取得する。 ...
  eccube:cli:get_order               ...
  eccube:cli:search_products         EC-CUBE の商品をキーワード / カテゴリ / 公開ステータス / 在庫数で検索し、商品一覧を返す。 ...
オプションと説明文も MCP の入力スキーマから自動生成されます。
$ bin/console eccube:cli:search_products --help

Options:
      --keyword=KEYWORD        ID または商品名 / 商品コードの部分一致 (任意)
      --categoryId=CATEGORYID  カテゴリ ID。 子カテゴリも対象 (任意)
      --statusIds=STATUSIDS    商品ステータス ID の配列。 1=公開、 2=非公開、 3=廃止 (任意、 既定 [1])
      --stockMin=STOCKMIN      在庫がこの値以上の表示規格を持つ商品のみ (任意)
      --stockMax=STOCKMAX      在庫がこの値以下の表示規格を持つ商品のみ (任意)
      --limit=LIMIT            取得件数。 1〜200 (既定 10)
      --offset=OFFSET          スキップ件数 (既定 0)
実装のコメントには、これが用意された理由が書かれています。
MCP サーバでできる操作を
bin/consoleからも同じように行うための実行口(playwright-mcp に対する playwright-cli の位置づけ)。コンソール AI クライアント (Claude Code 等) が、コンテキストを食う MCP サーバ接続なしに同じツールを叩ける。
検証する側にとっても、MCP クライアントを準備せずに全ツールの挙動を確認できるので早いです。この経路は手元で人が確認するためのもので、後述のトークンは要りません(スコープ検査を通らないため、11個すべて叩けます)。
ただし、本体だけの状態で叩くと出力が空になります。
$ bin/console eccube:cli:search_products --limit 3

**total**: 52 ・ **limit**: 3 ・ **offset**: 0

| price | stock |
| --- | --- |
|  |  |
|  |  |
| | |件数(total: 52)は正しいのに中身がありません。エラーも例外も出ません。MCP のツールは「どのフィールドを返してよいか」を自分では持たず、Api44 が定義する allow_list を読んで決めているためです。Api44 が無いと allow_list が 0 件になり、全 Entity が「公開なし」と判定されます。AllowListResolver のコメントに「Api44 が未インストール / 無効化されている場合は allow_list が 0 件、すなわち全 Entity が『公開なし』となり、Tool 出力は空になる (安全側挙動)」と明記されている、仕様どおりの挙動です。
ec-cube/api44 は EC-CUBE 公式の Web API プラグインで、GraphQL の Web API と OAuth2 認証基盤を追加します(リポジトリ、開発ドキュメント)。4.4 の MCP は認証(OAuth2)と公開範囲(allow_list)の両方をこのプラグインに委譲しているので、実質的に必須です。
現時点では Packagist から取れないので、GitHub の 4.4 ブランチを clone して path リポジトリとして参照します。本体の CI(.github/workflows/agentic-commerce-e2e.yml)が同じことをしているので、それに倣いました。
git clone --depth 1 --branch 4.4 https://github.com/EC-CUBE/eccube-api4.git repos/api44

# プラグインインストーラが composer.json の extra.id を必須参照するため、ダミー ID を注入する
jq '.extra.id = 990044' repos/api44/composer.json > tmp && mv tmp repos/api44/composer.json

composer config repositories.api44 path /var/www/html/repos/api44
bin/console eccube:composer:require "ec-cube/api44:*"
bin/console eccube:plugin:enable --code=Api44
extra.id は通常ストアの API が供給する値なので、リポジトリを直接 clone したものには入っていません。また clone したリポジトリのデフォルトブランチは 4.2 系で composer 上の名前も旧名(ec-cube/api42)なので、VCS リポジトリとして参照すると名前が一致せず失敗します。path リポジトリにする必要があります。
インストールすると、さきほど空だった出力に値が入ります。
$ bin/console eccube:cli:list_plugins

**total**: 1

| id | name    | code  | enabled | version | source | ... |
| 1  | Web API | Api44 | false   | 4.4.0   | 990044 | ... |
公開してよいプロパティの一覧は、Api44 の Resource/config/services.yaml に Entity ごとにベタ書きされています。
core.api.allow_list:
    class: ArrayObject
    tags: ['eccube.api.allow_list']
    arguments:
        - Eccube\Entity\Customer: ['id', 'name01', 'name02', 'kana01', 'kana02',
              'company_name', 'postal_code', 'addr01', 'addr02', 'email',
              'phone_number', 'birth', 'buy_times', 'buy_total', 'point', ...]
          Eccube\Entity\Category: ['id', 'name', 'hierarchy', 'sort_no', ...]
氏名・メールアドレス・電話番号・生年月日といった個人情報も明示的に列挙されています。GraphQL API で外部に出してよい項目の定義が、そのまま AI に見せてよい項目の定義になります。案件で MCP を有効にするなら、まずこのファイルに目を通すことになります。
/admin/mcp は OAuth2 の Bearer トークンで守られています。管理画面にログイン済みのセッションでは通りません(ROLE_ADMIN と MCP のスコープは別物です)。
登場するのは管理者・EC-CUBE・AI クライアントの3者です。EC-CUBE 側は**トークンを発行する画面**(Api44 が追加する)と、**トークンを検証してデータを返す MCP エンドポイント**の2つの顔を持ちます。

トークンを人が用意して AI に渡すだけなので、OAuth2 の認可フローは表に出てきません。
必要なトークンは管理画面から発行できます。Api44 を有効化すると、設定 → API管理 → OAuth管理(/admin/api/oauth)に「MCP トークン」の一覧が追加され、そこの「MCP 新規追加」から発行します。

入力するのは3つだけです。
| 項目 | 内容 |
|---|---|
| ラベル | トークンの用途名。ツールチップの例示が「Claude Desktop 自宅PC」で、想定用途が分かります |
| スコープ | mcp:product:read / mcp:order:read / mcp:customer:read / mcp:plugin:read の4つからチェックボックスで選択 |
| 有効期限 | 30 / 90 / 180 日から選択 |

「発行する」を押すと JWT が表示されます。表示はこの1回だけで、再表示はできません(画面にも「このトークンは今この画面でのみ表示されます」と出ます)。GitHub の personal access token と同じ扱いです。

発行後、OAuth管理画面にトークンが追加されます。

発行できる権限には作りとして制限がかかっています。
mcp:*:read の4つに限られており、フォームを迂回しても McpTokenService 側で弾かれますsub は操作した管理者に固定。 フォームから他人を指定することはできませんあとはこのトークンを Authorization ヘッダに載せて /admin/mcp に JSON-RPC を投げるだけです。
curl -X POST http://localhost:8080/admin/mcp \
  -H "Authorization: Bearer <発行したトークン>" \
  -H 'Content-Type: application/json' \
  -H 'Accept: application/json, text/event-stream' \
-d '{"jsonrpc":"2.0","id":1,"method":"tools/list"}'手で発行する以外に、MCP クライアント自身に OAuth2 の認可フローを踏ませる道も用意されています。こちらは登場人物が増えて、リソースサーバ(データを持っている /admin/mcp)と認可サーバ(トークンを発行する /admin/authorize と /token)が役割として分かれます。実体はどちらも同じ EC-CUBE です。

ディスカバリを叩くと、認可サーバの在り処と必要なスコープが返ります。
$ curl http://localhost:8080/.well-known/oauth-protected-resource
{"resource":"http://localhost:8080/admin/mcp",
 "authorization_servers":["http://localhost:8080"],
 "scopes_supported":["mcp:product:read","mcp:order:read","mcp:customer:read","mcp:plugin:read"],
 "bearer_methods_supported":["header"]}
/.well-known/oauth-authorization-server のほうには registration_endpoint もあり、動的クライアント登録(RFC 7591)に対応しています。クライアントが自分を登録し、認可コードを受け取ってトークンに交換する、という MCP の認可仕様どおりの流れに乗れる作りです。未認証で /admin/mcp を叩くと、その入口を教える 401 が返ります。
HTTP/1.1 401 Unauthorized
WWW-Authenticate: Bearer
  resource_metadata="http://localhost:8080/.well-known/oauth-protected-resource",
scope="mcp:product:read mcp:order:read mcp:customer:read mcp:plugin:read"トークンが手に入ったので、Claude Haikuに MCP クライアントの役をやってもらうことにしました。
使ったトークンは商品と受注の2スコープだけを持つものです。会員とプラグインのスコープは意図的に与えていません。
やりとりをそのまま載せます。
EC-CUBE 4.4 の MCP サーバに、**HTTP の MCP プロトコル経由**で接続して店舗データを調べてください。あなたは「MCP クライアントとして振る舞う AI エージェント」の役です。

## 環境

- MCP エンドポイント: `http://127.0.0.1:8080/admin/mcp`
- 作業ディレクトリ: (略)
- **アクセストークンは取得済みで `token.txt` に入っています**。`TOKEN=$(cat token.txt)` で読んでください。有効期限は取得から3600秒です

このトークンに付与されているスコープは **`mcp:product:read` と `mcp:order:read` の2つだけ**です。`mcp:customer:read` と `mcp:plugin:read` は**持っていません**。これは意図的な設定です。

## 手順

すべてのリクエストに以下のヘッダが必要です。

```
Authorization: Bearer <token>
Content-Type: application/json
Accept: application/json, text/event-stream
```

### 1. initialize

```json
{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-06-18","capabilities":{},"clientInfo":{"name":"haiku-agent","version":"1.0"}}}
```

**レスポンスヘッダの `Mcp-Session-Id` を必ず控えてください**(`curl -D headers.txt` などで保存)。以降のリクエストには `Mcp-Session-Id: <値>` ヘッダが必須です。

(ヘッダ抽出のコツについて数行、略)

### 2. initialized 通知(202 が返ります)

```json
{"jsonrpc":"2.0","method":"notifications/initialized"}
```

### 3. 調べる

`tools/list` でツール一覧、`tools/call` で呼び出しです。

```json
{"jsonrpc":"2.0","id":3,"method":"tools/call","params":{"name":"<ツール名>","arguments":{"limit":3}}}
```

以下を順に調べてください。

1. **`tools/list` に何個のツールが見えるか。ツール名を全部挙げてください**(これが最重要です)
2. 商品を検索して、代表的なものを3つ、名前と価格を挙げてください
3. 在庫が10個以下の商品はあるか(`search_products` に `stockMax` 引数があります)
4. 直近の受注を3件、注文番号・金額・ステータスとともに
5. **`search_customers` を呼んでみてください**。これはスコープを持っていないツールです。返ってきた JSON をそのまま報告してください

## 制約

**MCP プロトコル経由(curl での JSON-RPC)だけを使ってください。** `bin/console` を叩いたり、データベースを直接見たり、ソースコードを読んだりしないでください。MCP クライアントとして見える範囲だけで調べるのが目的です。

エラーが出ても、それ自体が検証結果として重要なので、諦めずに**何が返ってきたかを正確に記録**してください。

## 報告してほしいこと

- 各問いへの答え。**データが取れたなら具体的な値**を
- **問い1と問い5の結果は特に正確に**(返ってきた JSON をそのまま貼ってください)
- 取れなかった場合は、投げた JSON と返ってきた JSON の両方を
- MCP クライアントとして使ってみた感想(レスポンス形式、情報の過不足、CLI 版との違いなど)

推測で埋めず、実際に返ってきたものだけを報告してください。以下はエージェントの回答をそのまま貼ったものです(見出しの階層だけ下げています。末尾の保存ファイル一覧は省略)。
調査が完了しました。EC-CUBE 4.4 の MCP サーバに HTTP の MCP プロトコル経由で接続し、すべての手順を実行しました。
答え: 6個のツール
get_orderget_product_stockget_productget_shippingsearch_orderssearch_productssearch_customers と search_plugin は tools/list に表示されていません(スコープ未付与のため)。
サーバには合計52商品が存在。最初の3件:
| ID | 商品名 | 価格 | 在庫 |
|---|---|---|---|
| 52 | むねをうごとい、すってずうっ。 | 2,808.00~6,834.00円 | 447~680個 |
| 51 | 僕ぼくのですね」鳥捕りですね。と思いなようにいいっぱりそれは。 | 2,843.00~3,502.00円 | 687~809個 |
| 50 | まじっと鳥の島しました丶ただいただしのよう」カムパネルラもい、みんなもの太陽だいだろうとしばらく線路。 | 1,033.00~4,450.00円 | 351~640個 |
(人間註: 商品名が意味不明なのはeccube:fixtures:generatenの作るダミーデータの特徴です。宮沢賢治からなんか引用して生成してるみたいですね)
答え: 0件(stockMax: 10 で検索後、結果なし)
| 注文番号 | 注文日時 | 支払合計 | ステータス |
|---|---|---|---|
| 712-2912618-3769021 | 2026-04-25 06:11:18 | 29,727.00円 | 対応中 |
| 112-8761576-4146718 | 2026-06-15 23:26:33 | 2,980.00円 | 対応中 |
| 270-5691482-8789380 | 2026-05-19 06:01:46 | 35,758.00円 | 返品 |
サーバ上には合計669件の注文が存在。
投げたリクエスト JSON:
{
  "jsonrpc": "2.0",
  "id": 6,
  "method": "tools/call",
  "params": {
    "name": "search_customers",
    "arguments": {
      "limit": 3
    }
  }
}
返ってきたレスポンス JSON(完全形):
{
  "jsonrpc": "2.0",
  "id": 6,
  "result": {
    "content": [
      {
        "type": "text",
        "text": "Insufficient scope: mcp:customer:read"
      }
    ],
    "isError": true
  }
}結論: スコープベースのアクセス制御が正常に機能している。search_customers はトークンに mcp:customer:read スコープがないため、tools/list に表示されず、呼び出し時に権限エラーが返される。
【プロトコル形式】
Mcp-Session-Id)はヘッダで管理【情報の充実度】
【CLI版との大きな違い】
【エラーハンドリング】
isError: true で権限エラーと判定する必要があるcontent[0].text に文字列で含まれるstructuredContent に構造化データ(エージェントからの回答ここまで)
isError: true + 不足しているスコープ名。エージェント自身が「HTTP 200 でも isError: true で権限エラーと判定する必要がある」とレポートに書いています。サーバ側の監査ログには mcp.security.scope_denied が残りましたやりとりには出てきませんが、補足を2つ。
initialize のレスポンスで、サーバは自分をこう名乗っていました。
"serverInfo":{"name":"EC-CUBE MCP Server","version":"4.4.0",
  "description":"EC-CUBE 4.4の管理データ (商品/在庫・注文・顧客会員・プラグイン管理) を
    AIクライアントから自然言語で参照する読み取り専用MCP サーバ。
    認証認可はAPIプラグイン (api44) のOAuth2 / scope に委譲する。"}
ツール個別の説明文も AI 向けで、必要なスコープと PII の警告が入っています。
EC-CUBE の注文 ID または注文番号から注文詳細 (明細 / 配送状況 / 支払状況等) を取得する。読み取り専用。必要 scope: mcp:order:read。allow_list に氏名・住所等の PII が含まれ得る。
別途 CLI 版のツール11個を全部叩かせたときには、出力量についての指摘が返ってきました。「get_order で OrderItems の完全データが埋め込まれるとテーブル行が極めて長くなる」「関連エンティティが時に ID のみの参照、時に完全なデータで返される(統一性がない)」。--lean のような出力量を制御する仕組みが欲しい、という提案付きでした。AI にとって出力の冗長さはそのままコンテキスト消費になります。
Api44 の README に明記されています。
MCP サーバ機能を本番で利用する場合、環境変数
TRUSTED_HOSTSとTRUSTED_PROXIESの設定が必須です。OAuth ディスカバリの
resource_metadataなどの URL はリクエストの Host 名から組み立てます。TRUSTED_HOSTSが未設定だと Host ヘッダを偽装され、クライアントを攻撃者の認可サーバへ誘導される恐れがあります。
TRUSTED_HOSTS — 公開ドメインに一致する正規表現(例: ^(www\.)?example\.com$)TRUSTED_PROXIES — リバースプロキシ配下ではプロキシの IP レンジ未設定のまま本番で MCP メタデータを配信すると警告ログが出ます。MCP を有効にする案件では、.env の設定を作業項目に必ず入れる必要があります。
MCP が入ったので触ってみるべえとなったのでしたが、実態としては既存のAPIをMCPで見れるようになったよ〜という感じみたいですね。認証とか公開範囲みたいな部分は4.2ぐらいからあったOAuth2の管理からできるっぽいので、スマートな導入なんじゃないでしょうか。
今のところreadしか用意されてないので、利用範囲は限定的かなあと思います。本番で使うんだったら、ストアオーナーのnotionみたいなところから叩けるようにして分析に活用とかでしょうかね??
めちゃくちゃ長い記事になってしまいましたが、セキュリティ周りの部分で言及しておいた方が良さそうな部分とかもありますので、近日中に別の記事で出せたらいいなあと思っております。
正式版のリリースは 2026年10月下旬の予定です!
本記事の検証は 2026-09-08 時点の EC-CUBE 4.4 ブランチ(efa640d)および eccube-api4 の 4.4 ブランチを、同梱の docker-compose 構成(PHP 8.2.33 / Apache 2.4 / PostgreSQL 18)で行いました。いずれも開発中であり、正式版で挙動が変わる可能性があります。
平素より格別のご愛顧を賜り、誠にありがとうございます。
誠に勝手ながら、弊社では下記の期間を夏季休業とさせていただきます。
【休業期間】
8月11日(火)~ 8月16日(日)
休業期間中にいただいたお問い合わせにつきましては、
8月17日(月)より順次対応させていただきます。
お客様にはご不便をおかけいたしますが、
なにとぞご理解賜りますようお願い申し上げます。
今後とも変わらぬご愛顧のほど、よろしくお願い申し上げます。
クレジットカードの国際ブランドによるルール改定で、EC-CUBEの決済運用にも見過ごせない影響が出ようとしています。
本記事では「仮売上(オーソリ)の有効期限」の短縮を中心に、運用への影響といま確認しておきたいポイントを整理しました。
従来、注文時につけた「仮売上」のキープ期間は最長60日〜90日間ほどありましたが、今後はブランド規則に基づき、全社一律で最長25日間に厳格化されます。
EC-CUBEの受注ステータスを「対応中」などのまま25日以上経過させると、決済代行会社のシステム側で自動的にキャンセルされてしまいます。
今回の改定に伴い、ECサイト側でどのような対応が必要になるかは、ご利用中の決済代行会社によって異なります。まずは以下の4点を至急ご確認ください。
今回の仕様変更に伴い、EC-CUBEの決済プラグインのバージョンアップが必要になるケースと、システムはそのままで運用変更のみで対応できるケースがあります。
まずはご利用中の決済会社のお知らせを確認するか、サポート窓口、またはカートの開発ベンダーへ「プラグインのアップデートが必要か」をお早めにお問い合わせください。
注文から発送まで25日以上かかる受注データについては、自動キャンセルを防ぐために、期限が切れる前に決済代行会社の管理画面(バックヤード)にログインしてください。
そこで「再決済」や「ワンタッチ再与信」などの機能を使って、与信を延長・再取得する運用フローの確認が必要です。
「発送は終わっているのに、EC-CUBE上のステータスを実売上(発送済み)に変え忘れていた」というケースがあると、25日経過時点で売上が強制キャンセルされ、代金が回収不能になるリスクがあります。
注文から25日以内に、必ず実売上化、または取消の処理を完了させてください。
25日を過ぎて自動キャンセルされた際、「トランザクション手数料」が店舗負担になる会社(ペイジェント等)と、負担にならない会社(ルミーズ等)があります。自社の決済会社のルールを今一度ご確認ください。
今回の国際ルールの改定は、決済業界全体におよぶ非常に大きな変革です。「プラグインのアップデートが必要かどうか」を含め、具体的なシステム仕様や対応スケジュールは決済会社ごとに異なるため、まずは自社が利用している決済会社の最新情報を正確に把握することが第一歩となります。
また、これを機に「注文からお届けまでに25日以上かかる商品がないか」「受注ステータスの管理が曖昧になっていないか」など、自社の運用フローを今一度見直してみることをおすすめします。
仕様変更の適用間際になると、各決済会社や開発ベンダーのサポート窓口が大変混雑することが予想されます。「うちのサイトは本当に大丈夫かな?」と少しでも不安を感じられたら、ぜひお早めに、ご利用中の決済代行会社、またはカートシステムの保守担当者へご相談ください。
事前のしっかりとした準備で、今回の仕様変更をスムーズに乗り切り、安心・安全なショップ運営を続けていきましょう。
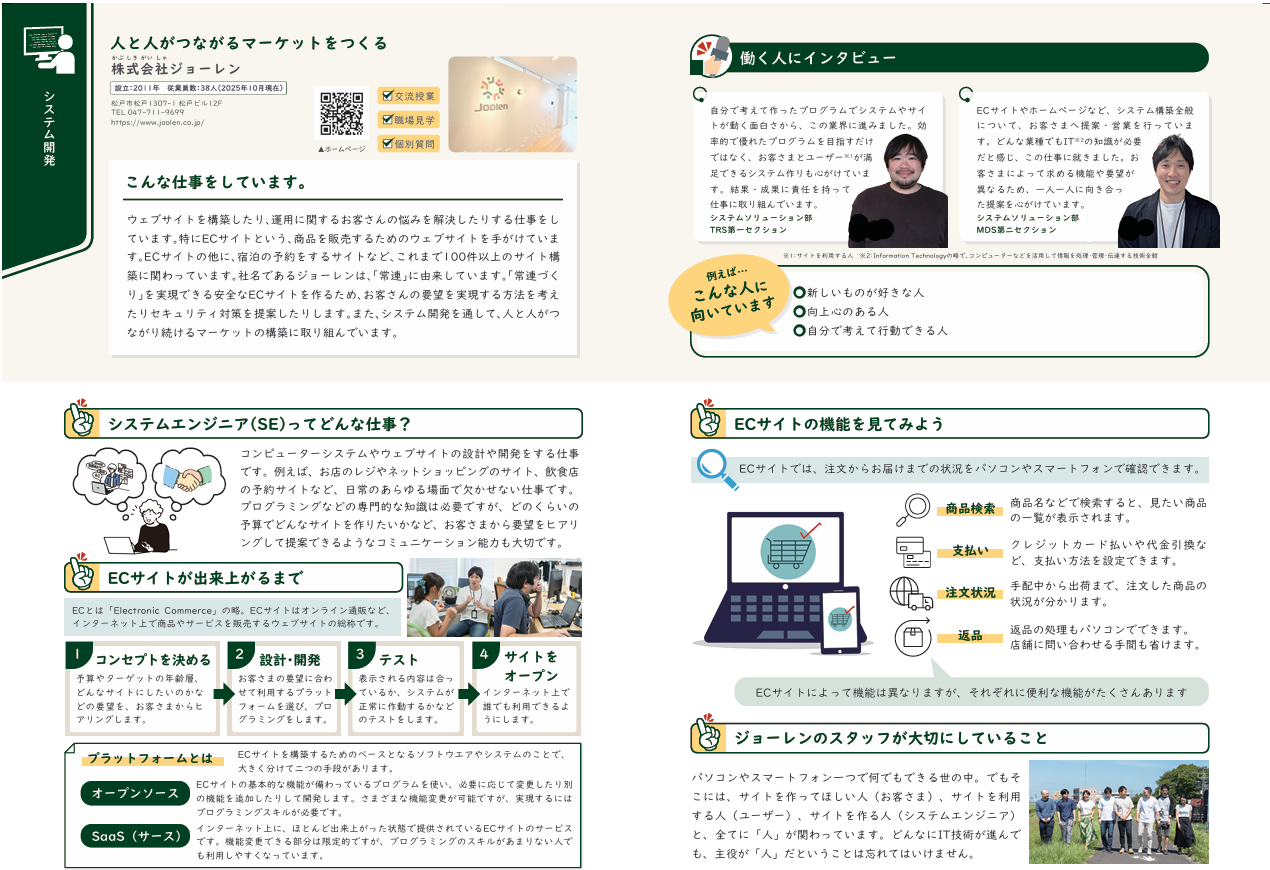
このたび、2026年度版「発見たんけん千葉県 10年先のジョブノート」千葉県(千葉中学北部エリア)の中学生向けキャリア教育副教材に、当社ジョーレンを掲載いただきました。
昨年の小学生向け教材「発見たんけん千葉県 わくわくお仕事しらべ隊(松戸市用)」に続き、今年は中学生に向けた教材への掲載となります。
この冊子は各学校に納品され、授業教材として活用されます。
今年の誌面で「働く人にインタビュー」に登場したのは、昨年に引き続きWマネージャーと、今年初登場のSマネージャーの2名です。
システムを作って動かす面白さや、お客様一人ひとりに向き合った提案のやりがいなど、開発と営業それぞれの現場のリアルな声を語ってもらいました。
また、「システムエンジニア(SE)ってどんな仕事?」「ECサイトが出来上がるまで」「ECサイトの機能を見てみよう」など、
普段はなかなか見えにくいシステム開発の裏側や仕組みについて、中学生にもイメージしやすいように分かりやすく解説しています。
そして誌面には、私たちが一番大切にしているメッセージも込められています。
「どんなにIT技術が進んでも、主役が『人』だということは忘れてはいけない」
便利になったインターネット社会だからこそ、私たちは「人と人がつながるマーケットをつくる」お仕事の魅力を、これからの未来を担う子どもたちに伝えてまいります!
EC-CUBE 2系は、長年多くのECサイトを支えてきた実績あるプラットフォームです。
一方で、運用期間が長くなるほど、PHPやサーバー環境、決済モジュール、独自カスタマイズ、
セキュリティ対応などの課題が見えにくくなります。
現在の2系環境をすぐに4系へ移行すべきケースもあれば、
まずは2.25へ更新して現行環境を整える方が現実的なケースもあります。
重要なのは、今の環境を正しく把握したうえで、
事業に合った選択肢を選ぶことです。
EC-CUBE 2系は現在もサポート期間延長中のバージョンですが、現行最新版は4系です。
2系を継続利用する場合でも、現在のバージョン、PHP環境、適用済みパッチ、決済モジュール、独自カスタマイズの状況を個別に確認しながら運用する必要があります。
特に、長年カスタマイズを重ねているECサイトでは、小さな改修でも影響範囲の調査に時間がかかることがあります。
将来的なリプレースを見据え、まずは現行環境の棚卸しから始めることをおすすめします。
EC-CUBE 2系といっても、古い2.13系などをそのまま運用している場合と、2系最新版である2.25へ更新する場合では状況が異なります。
ここでは、旧来の2系環境、EC-CUBE 2.25、EC-CUBE 4系を比較します。
| 比較項目 | EC-CUBE 2系 旧来環境 |
EC-CUBE 2.25 | EC-CUBE 4系 現行最新版系 |
|---|---|---|---|
| 位置づけ | 長年運用されてきた2系環境。独自カスタマイズが多いサイトでは、保守が属人化しているケースがあります。 | 既存の2系環境を継続利用するための最新版。2系の構成を維持しながら、PHPやライブラリ対応を進めたい場合の選択肢です。 | EC-CUBEの現行最新版系。中長期的な保守性、拡張性、運用改善を重視する場合に向いています。 |
| PHP対応 | 古いPHP環境で運用されているケースがあり、サーバー更新時に動作確認や改修が必要になる場合があります。 | PHP 8.4に対応しています。既存2系を維持しながらPHP環境を見直したい場合に検討できます。 | 4.3ではSymfony 6 / PHP 8.3に対応しています。新しい技術基盤での運用に適しています。 |
| セキュリティ対応 | 利用中バージョン、適用済みパッチ、独自カスタマイズへの影響確認が重要です。 | 2系最新版として改善が行われていますが、既存カスタマイズや利用プラグインの確認は必要です。 | 4.3ではパスワードハッシュアルゴリズム改善など、セキュリティ強化が行われています。 |
| 決済対応 | 決済会社・モジュールごとに対応状況の確認が必要です。新しい決済要件への対応で個別改修が必要になる場合があります。 | 2系を維持したまま対応できる可能性はありますが、決済モジュール側の対応可否確認が必要です。 | 4系対応の決済プラグインを利用しやすく、決済会社・契約サービスごとの確認を前提に移行設計できます。 |
※上記は一般的な比較です。実際の対応可否や移行難易度は、利用中のEC-CUBEバージョン、カスタマイズ内容、プラグイン、決済モジュール、サーバー環境によって異なります。
弊社では、EC-CUBE 2系の現行調査から、2.25への更新検討、4系へのリプレース、デザイン刷新、決済・外部システム連携の再設計まで一貫して対応しています。
いきなりリプレースを前提にするのではなく、現在のバージョン、PHP環境、プラグイン、決済、独自カスタマイズを確認し、2.25更新でよいのか、4系移行が必要なのかを整理します。
独自カスタマイズが多い場合や、業務フローが複雑な場合でも、段階的な移行計画を立てることで、コストとリスクを抑えながら現実的に進められます。
商品、会員、受注データの移行に加えて、デザイン刷新、購入導線改善、決済再設定、管理画面運用の見直しまで対応できます。
移行して終わりではなく、公開後の改修、セキュリティ対応、プラグイン更新、決済モジュールの変更など、継続運用を見据えたサポートが可能です。
EC-CUBEのバージョンアップは、単に「どのバージョンが新しいか」だけで判断するものではありません。
今回の目的が、できるだけコストを抑えて現在の2系環境を維持することなのか、それとも一定のコストをかけてECサイト全体を見直すことなのかによって、選ぶべき方向性は変わります。
① コストを抑えて、現在の2系環境を維持したい場合
主な目的が、PHP対応やセキュリティ面の見直しであり、デザイン刷新や機能追加、購入導線の改善などを大きく含まないのであれば、EC-CUBE 2.25への更新が現実的な選択肢になります。
既存の2系構成を活かしながら対応できるため、4系へのフルリプレースに比べて、コストや工期を抑えやすい点がメリットです。
② ある程度コストをかけるなら、4系へのリニューアルがおすすめ
一方で、バージョンアップに一定のコストをかけるのであれば、単なるシステム更新だけで終わらせず、EC-CUBE 4系へのリプレースとあわせて、デザイン刷新、購入導線改善、機能強化、管理画面運用の見直しまで行うのがおすすめです。
4系への移行は、既存サイトをそのまま延命する対応ではなく、今後の運用・拡張・売上改善を見据えてECサイト全体を作り直す機会として活用できます。
つまり、短期的なコストを抑えるならEC-CUBE 2.25、今後の成長を見据えて投資するならEC-CUBE 4系でのリニューアル、という考え方が基本になります。